Chrome 扩展自用中
新词发现系统
把手工查词变成一条自动流水线
一个 Chrome 扩展:从飞书里的词根出发,借 Google Trends 递归发现相关词,再用搜索结果页和 Ads Keyword Planner 验证,结果写回飞书。
01核心能力
它能做什么
- 01词根进去,结果出来
从飞书词根库或手动输入的词根开始,自动完成相关词发现、趋势判断、搜索验证,最后把结果写回飞书表格。
- 02递归发现
沿着 Google Trends 的相关查询逐层往下找,最多 3 层;长尾词不按词数限制,不会因为词长丢掉线索。
- 03趋势分级有理由
按六级规则判断走势,每个结论都写明理由。被淘汰的词再用 7 日均线复核,只会新增合格的词,不会让原本合格的词落选。
- 04自动跳过整句
明显是一句话的相关词(带问号、题目选项、特别长、有从句等,至少两项证据)会被规则过滤并写明原因,省下无效查询。
- 05后台安静运行
研究在当前窗口的「关键词研究」标签组里后台进行,不切走正在看的页面,也不需要守着。
- 06和观测台联动
可以领取观测台每天挑出的待查词,逐个查询后把结果回传;发送失败的留在本地队列,之后补传。
02界面一览
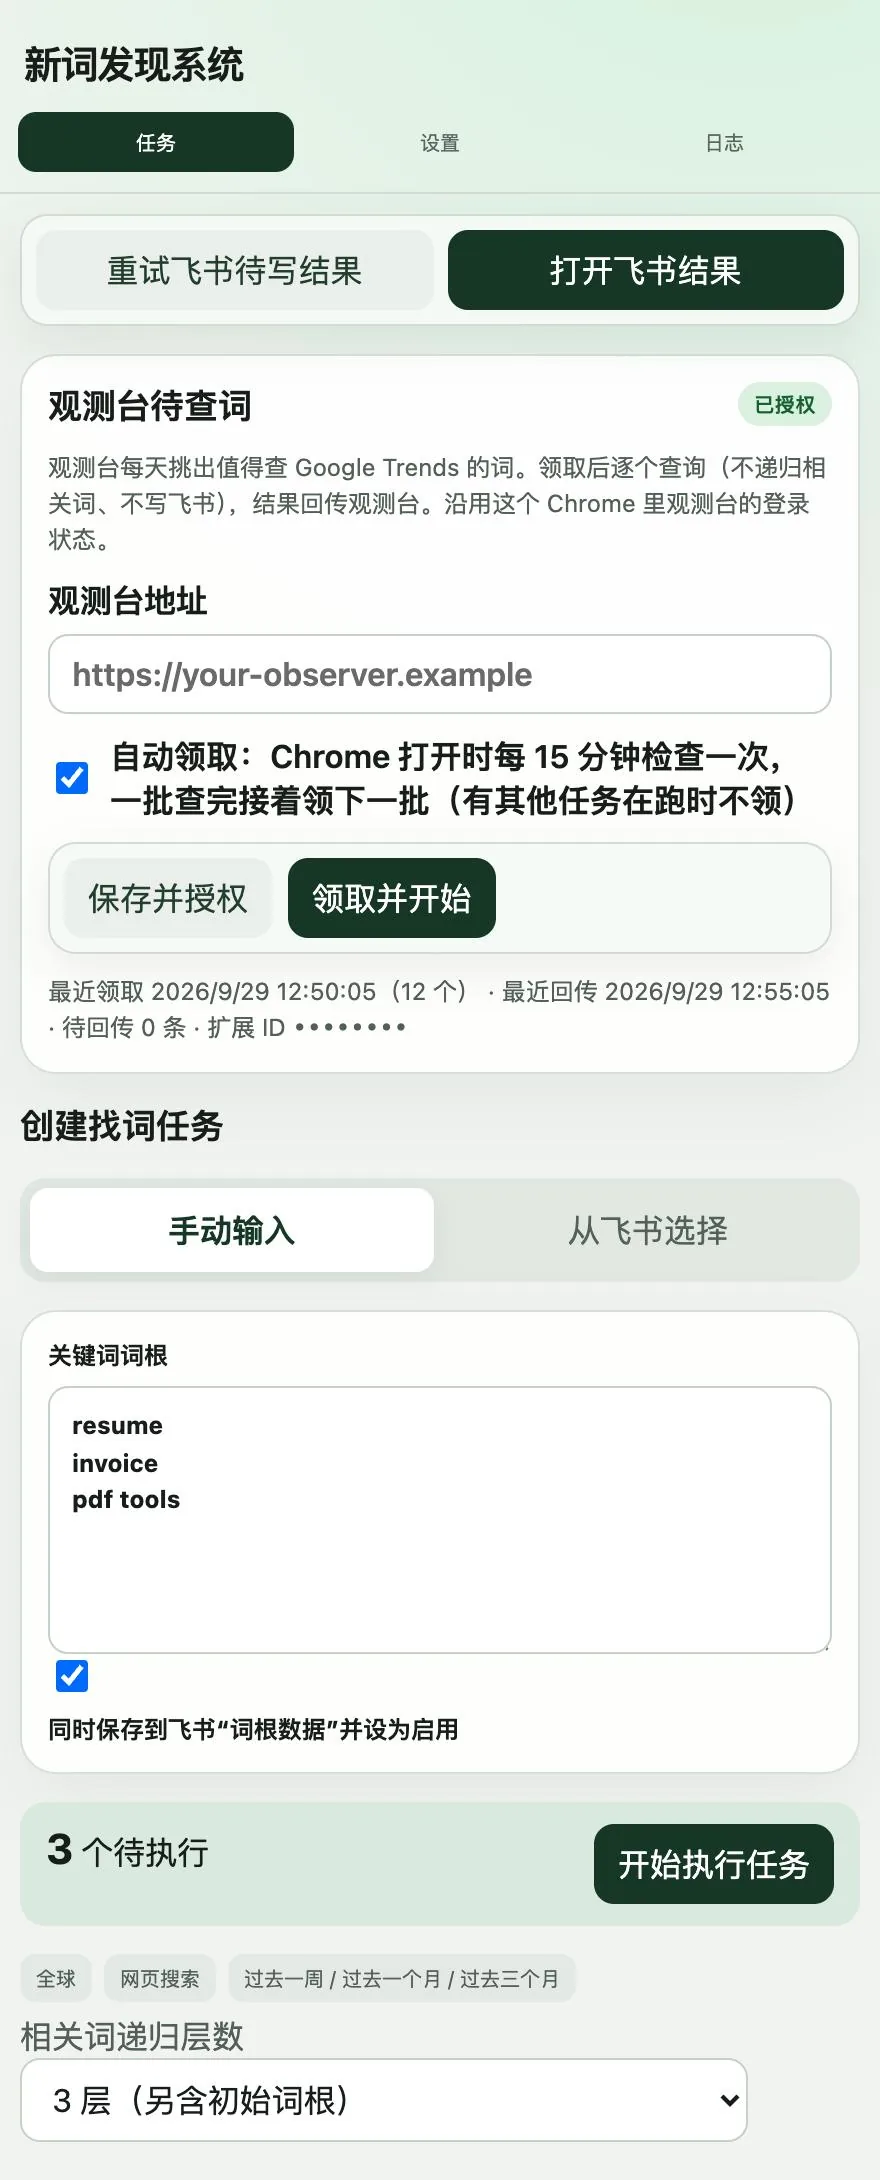
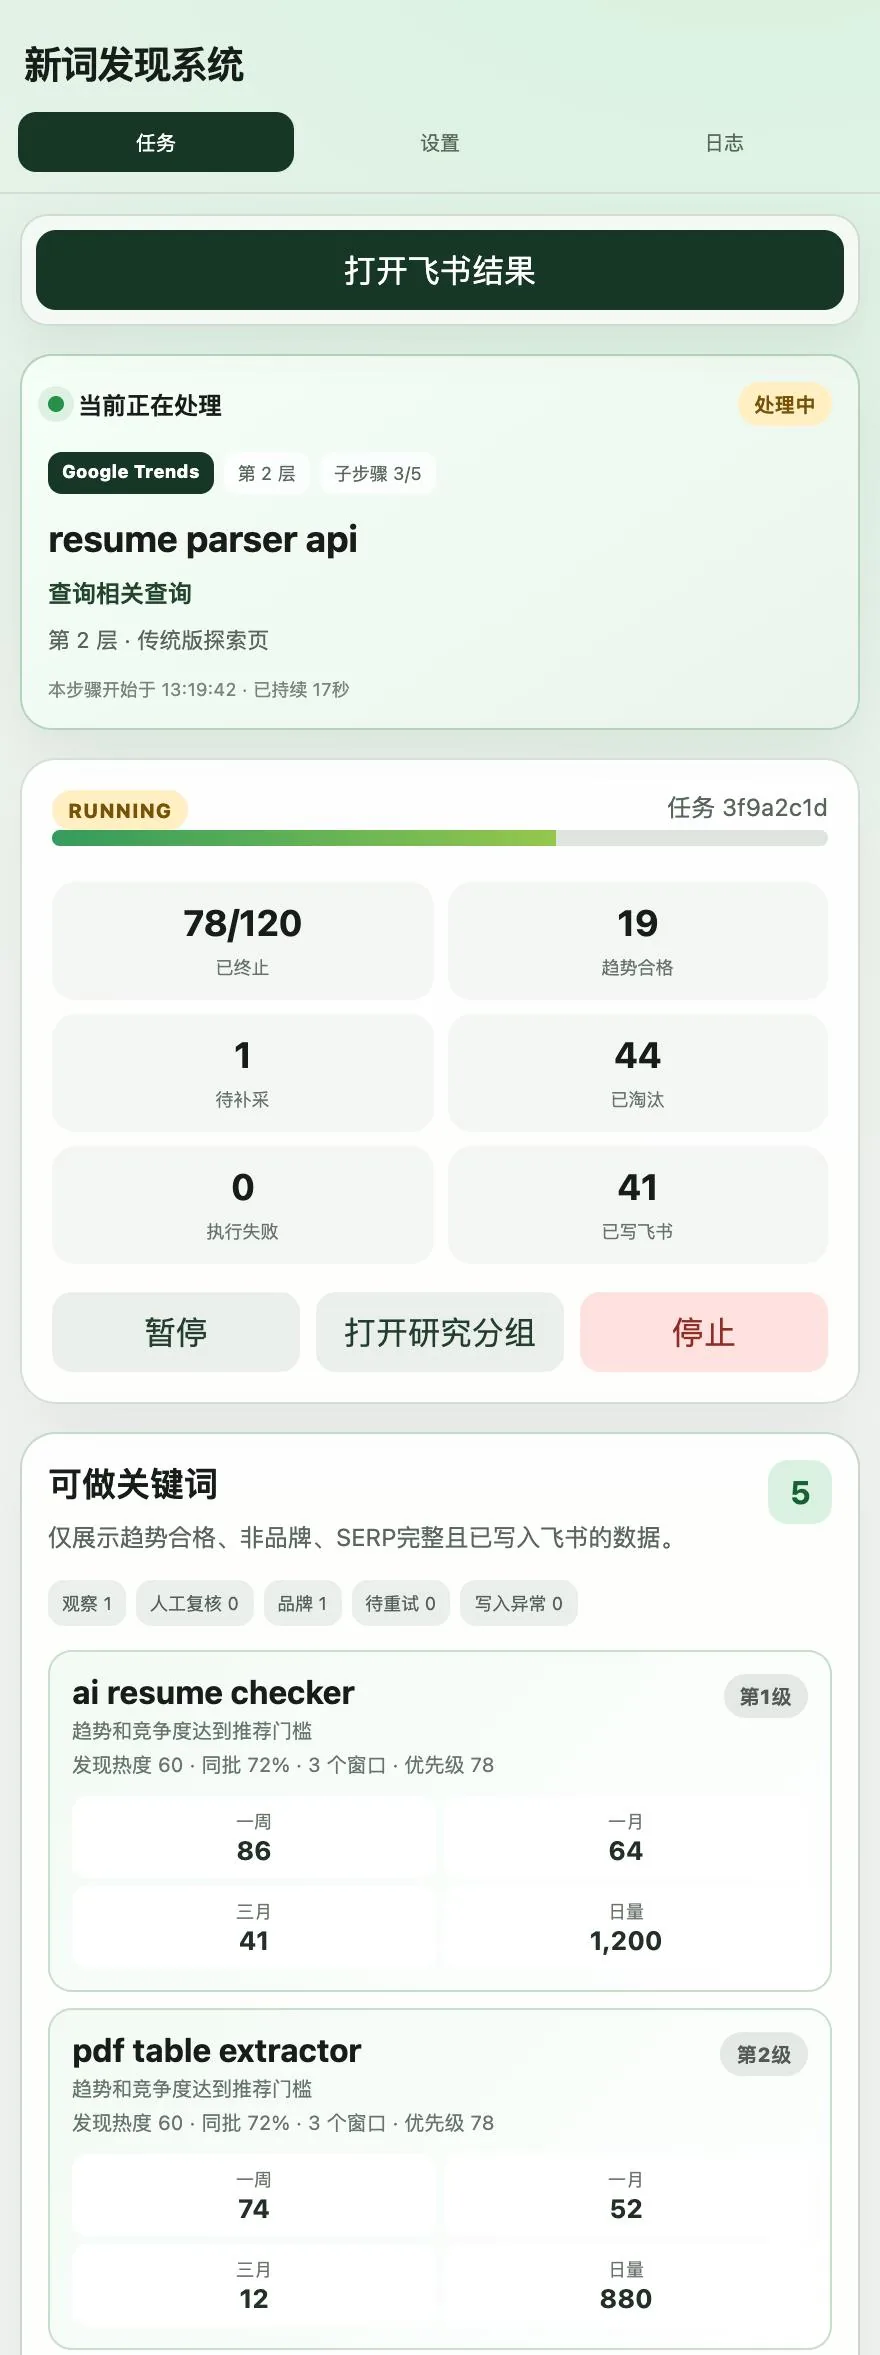
截图为扩展的真实界面,其中的关键词和数字均为演示数据。
03详细介绍
为什么做它
手工查新词的流程很碎:打开 Trends 看曲线,点相关查询,再一个个去搜,一个个记到表格里。量一大,判断标准也会漂移:今天觉得该留的词,明天可能就放过了。
这个扩展把它变成一条流水线:词根进去,带着趋势判断和搜索数据的结果出来,直接写回飞书。规则固定下来,每个词为什么留、为什么淘汰,都能查到理由。
流水线
- 读取飞书里的词根任务,或手动输入词根。
- 在 Google Trends 传统版「探索」页面查相关查询,按规则递归。
- 对每个词做趋势分级,并写明理由,包括「平滑复核」这类复核结论。
- 通过的词继续查搜索结果页和 Ads Keyword Planner。
- 结果写回飞书;被过滤的词也保留原因,方便回头核对。
实现方案:流水线每一步在干什么
- 任务编排:service worker 编排整个任务,研究在当前浏览器窗口的「关键词研究」标签组里后台执行,不切走当前页面。后台标签会被告知「页面可见」——传统版 Trends 只在可见时才加载相关查询,而且趋势规则是按传统版每小时一点的曲线粒度调的,所以整条流水线固定用传统版。
- 递归发现:词根 → 传统版「探索」页的相关查询 → 逐层往下,最多 3 层。长尾词不按词数限制;明显是一句话的词(带问号、题目选项、特别长、有从句、「人称+动词」——至少两项证据)直接被规则过滤并写明原因,不花查询配额。
- 趋势分级是规则判断:六级规则先判;被淘汰的词再用 7 日均线做平滑复核,只会新增合格的词,不会让原本合格的词落选。每个词保留「为什么留、为什么淘汰」的书面理由;飞书只写合格词,淘汰词留档备查。
- 搜索验证:通过的词继续查搜索结果页和 Ads Keyword Planner,拿到搜索端的数据再写回。
- 限流自愈:页面出现 429 或「sent too many requests」时,先用对照词查一次,分清是限流还是这个词自己的问题;确认限流后任务暂停 30 分钟,连续限流时间翻倍、最长 4 小时,被打断的词放回队列、不计重试次数。
- 结果落库:写回飞书多维表格;和观测台联动时逐词查询、逐词回传,发送失败的留在本地队列之后补传。
AI 在这条流水线里的位置:只做辅助判断,不碰趋势结论——分级完全由规则算出。AI 连续失败两次时,工具栏图标亮红色感叹号并显示原因,不会静默降级;从观测台领来的词不调用 AI。
设计上的取舍
- 只用传统版 Trends:新版页面只有在屏幕上才加载相关查询,曲线粒度也不同;趋势规则是按传统版的数据粒度调的,所以统一使用传统版。
- 限流时自己等:遇到 Google 限流会自动冷却、到点继续,被打断的词不计入重试次数。
- AI 只做辅助:连续失败两次时,工具栏图标会亮红色感叹号并给出原因,不会悄悄降级。
使用边界
- 凭证只保存在 Chrome 本地,打包文件不含任何用户配置。
- Ads Keyword Planner 需要单独启用,并授予站点权限。
- 目前以本地加载的方式自用。