新词趋势观测台
先看证据,再决定要不要建站
英文 AI、SaaS 与搜索流量建站机会的个人研究工作台:把分散的讨论、榜单和新词收进同一个地方,每条信号都能追溯到原文,最后由我自己判断值不值得做。
它能做什么
- 01新词雷达
把所有来源标题里的 1–3 词短语,与近 60 日历史对比,分成首次出现、升温、持续和基线期,每个词附原文样本和验证入口。
- 02需求卡
从 Reddit、Hacker News 等公开讨论里挑出真实需求,抽成「谁、想做什么、卡在哪」,随时可以点开原文和回复核对。
- 03方向归并
需求卡自动归入 17 个固定方向,如自动化工作流、电商运营、表格助手等,每类显示数量和带付费线索的条数,先看全局再往下钻。
- 04产品观察
Roblox 游戏、收入增长榜、App Store、Chrome 扩展、Product Hunt 新品分栏展示,每个对象带数字和较约 1 天前的变化。
- 05三种处理
每个对象只有加入观察、跳过、不可做三条出路。跳过的对象在数字大变时会自动回来,不会因为一次「不感兴趣」就永远错过。
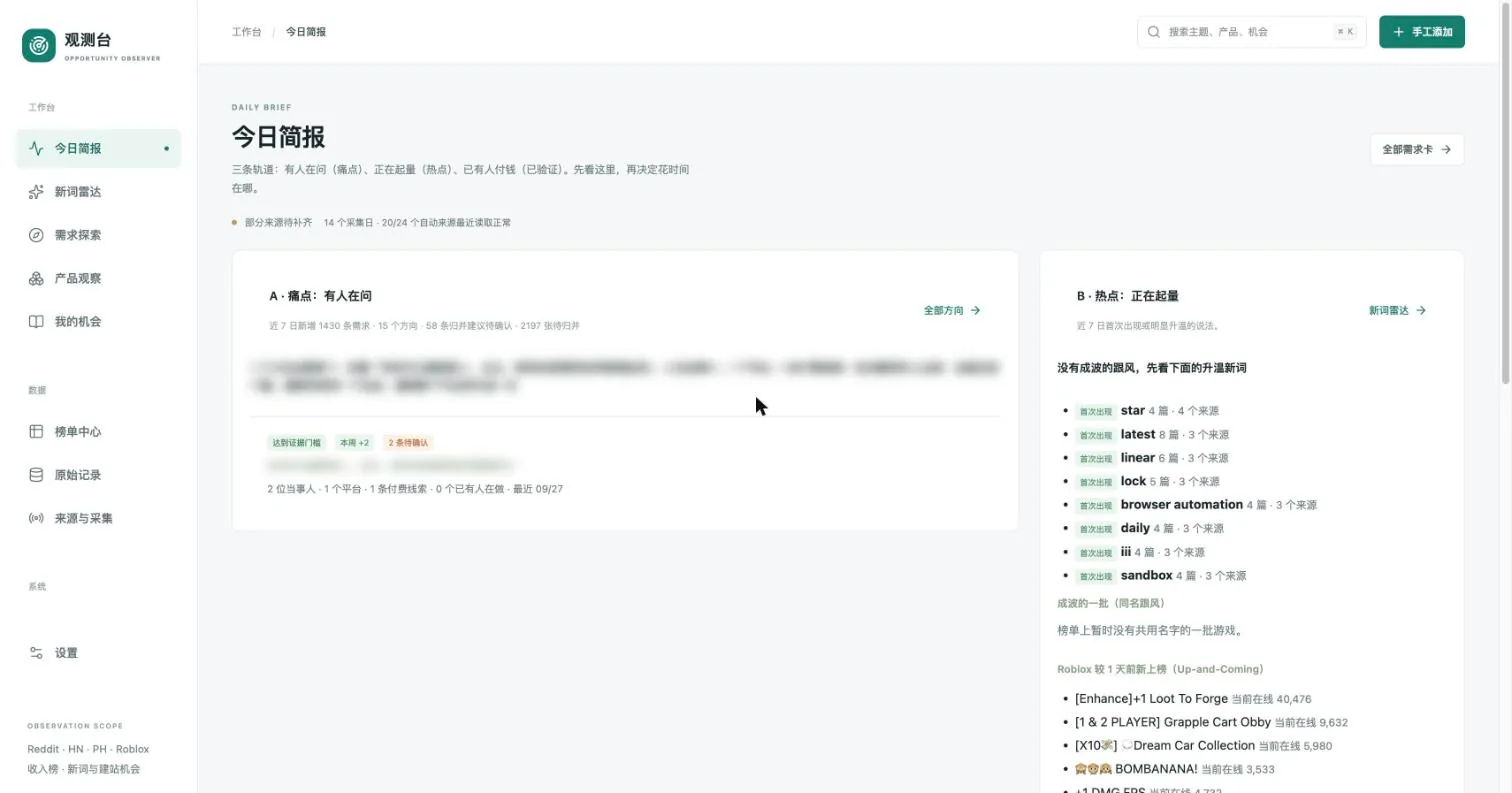
- 06今日简报
按「有人在问(痛点)、正在起量(热点)、已有人付钱(已验证)」三条轨道汇总,先看这里,再决定把时间花在哪。
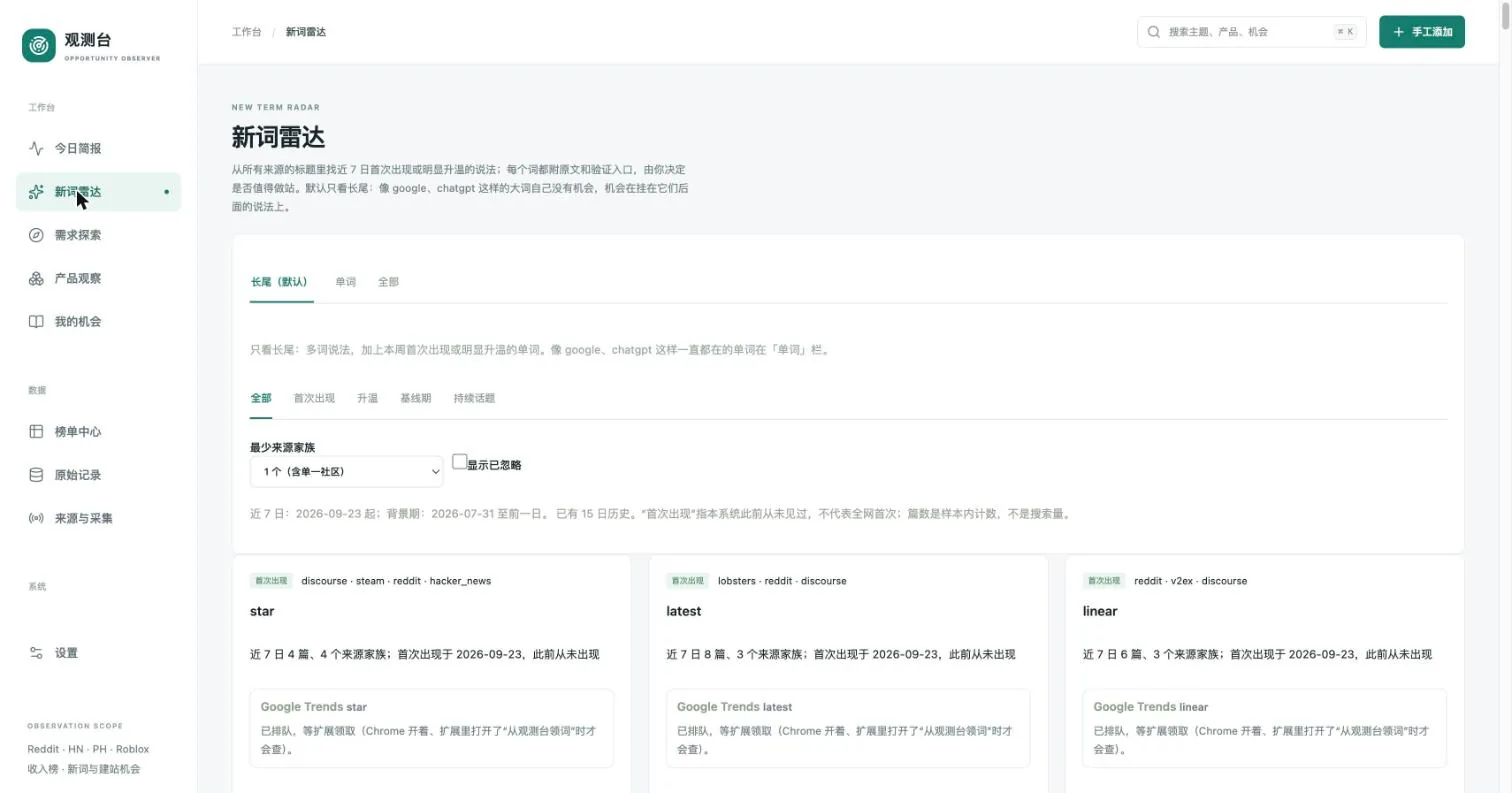
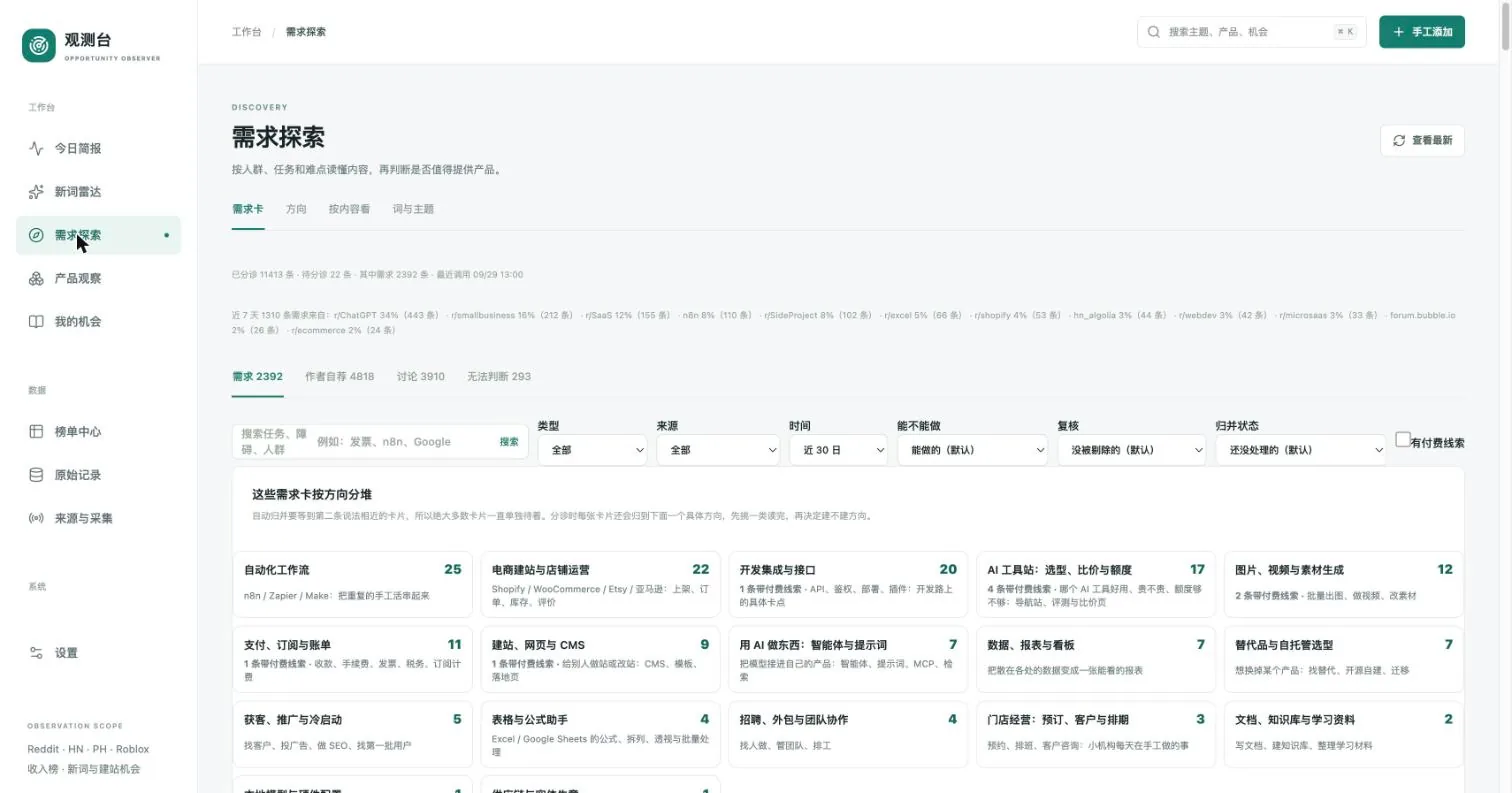
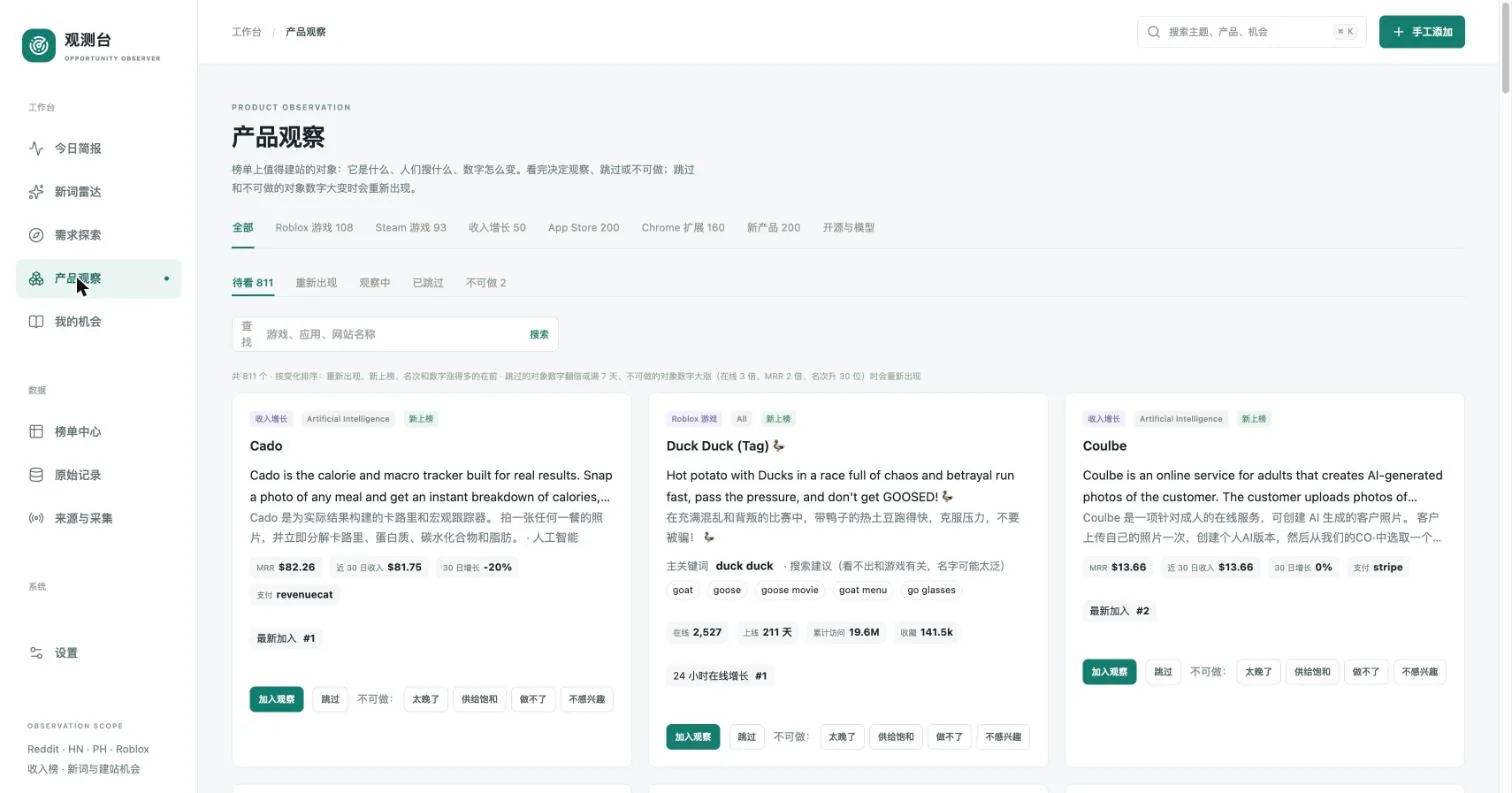
截图来自真实运行的版本,涉及个人研究方向的内容已做模糊处理;其余为公开的第三方榜单与社区数据。
为什么做它
找建站方向容易掉进两个坑:刷信息流,看到什么算什么;或者凭感觉判断一个词「好像在涨」。两种做法都没有证据,也留不下可以复盘的记录。
观测台把信号收进同一个地方:榜单、社区讨论、新品发布、新词,每条都保留来源和原文;再一层层收窄,从「有很多信号」到「有几个方向证据够了」,最后才轮到我做判断。截至 2026 年 9 月底,它已经分诊了一万多条讨论,从中提炼出两千多张需求卡。
从信号到判断
- 采集:定时读取公开的榜单、社区讨论和新品发布,失败时暂停并留下记录。
- 分诊:AI 把讨论里的需求抽成需求卡,并归入固定的方向类别。
- 挑选:在列表里逐条处理,看原文,加入观察、归入方向或标为不是需求。
- 研究:方向里证据够了,再去验证搜索需求和竞品,决定要不要建站。
实现方案:信号是怎么被采集和分诊的
- 采集层:15 个来源适配器按各自的节奏定时抓——Hacker News 一小时一次、GitHub 榜单一天一次、发布平台按各自间隔。五分钟内对同一目标的重复检查自动合并;失败会暂停采集并留下记录,不静默丢数据。全部是公开数据源,没有付费数据 API,也没有模拟的热度数字。
- 分诊层:讨论进来后 AI 做三轮筛选——分诊、「能不能做成产品」、复核。但 AI 结论只当标签,不直接决定去留;页面上只有我的三个状态:待确认、先放着、可以做。被 AI 筛掉的内容也收在页面底部一行,随时抽查、随时翻案。
- 分诊范围是拿数据调出来的:上线两周后按真实留存率收窄来源——Show HN / Launch HN 一千四百多条全是作者自荐,不再进需求分诊;Reddit 整版块新帖只有 2.2% 留得下来,改成只走「Reddit 站内搜索」的求助说法,命中率到 22%。AI 预算花在哪,由线上数据说了算,不靠感觉。
- 新词雷达:从所有来源标题里抽 1–3 词短语,与近 60 日历史对比,标成首次出现/升温/持续/基线期。基线攒满 14 天之前,系统不说「这是新词」,只标基线期——宁可少下结论,也不把噪声当信号。
- 需求卡能回到原文:每张卡存原始链接,点开按公开接口(Reddit RSS、HN Algolia、Discourse JSON)拉全文和回复。先看内容再决定,不看 AI 的摘要做判断。
- 判断是记录,不是状态位:我对每条的处置单独存一张表,删过的帖子再从任何来源出现都不会再入库;跳过的对象在数字大变时自动回到「重新出现」,不会因为一次「不感兴趣」就永远错过。
几个设计上的取舍
- 基线不够不下结论:系统的历史不满 14 天,就不会说某个词是「新词」,只标注基线期。
- 计数是样本,不是搜索量:页面明确写着「篇数是样本内计数」,避免把噪声当成需求。
- 只整理证据,不预测:它不告诉我哪个词会火,只帮我更早看到信号,并把证据摆整齐。
- 逐段可查:原文弹窗支持连着看、逐段翻译,处理完一条直接进入下一条。
使用边界
- 这是个人研究工具,整站只允许本人访问。
- 涉及付费线索、竞争度的判断,仍然需要我自己去验证。
技术底座
运行在 Cloudflare 上:Workers 提供页面与 API,D1 存业务数据,R2 存归档,Queues 承接采集任务,并有每日备份。它可以配合 Chrome 扩展「新词发现系统」,把待查的词交给扩展去查 Google Trends。